一、产品定位
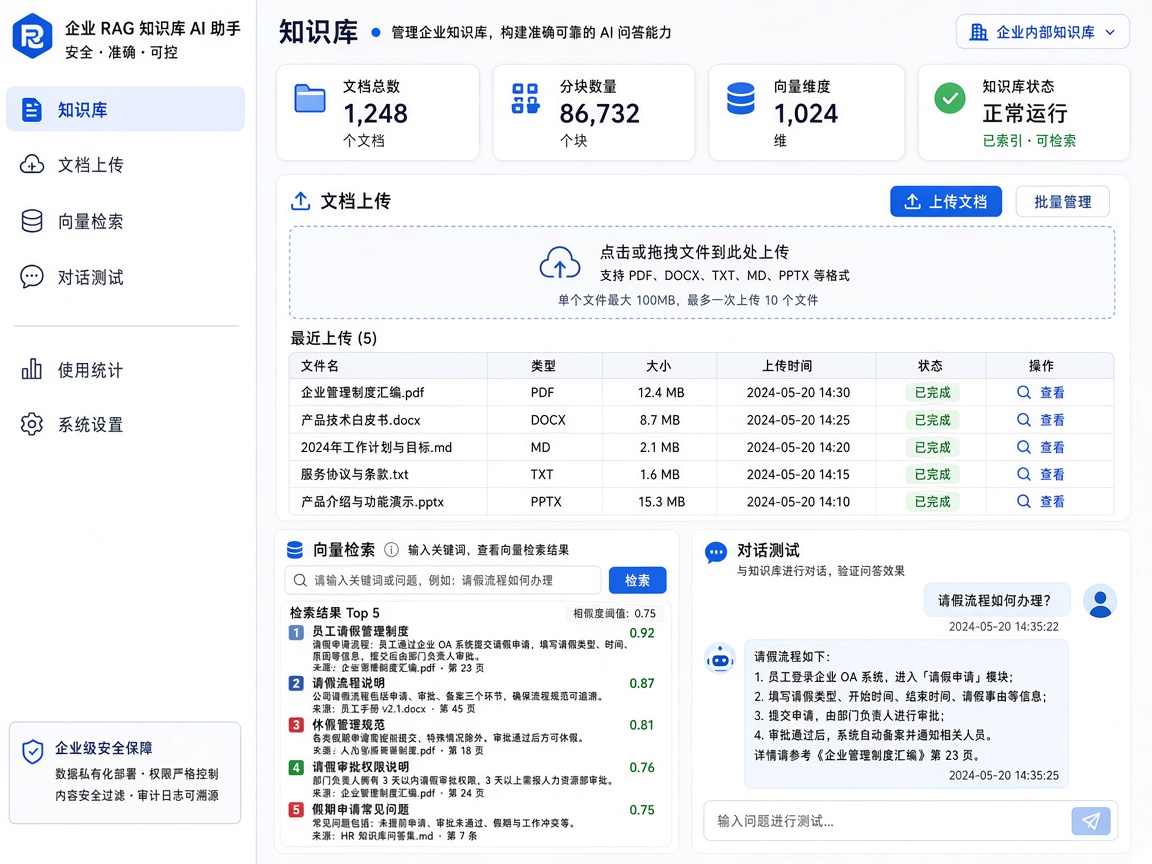
企业知识库 RAG Agent是长境面向「文档多、制度杂、数据散、合规严」组织打造的知识增强型 Agent 产品。它不只是「上传 PDF 就能问」的简易问答,而是覆盖 Ingestion → Chunking → Indexing → Retrieval → Generation → Governance 全链路的生产级 RAG 系统,并融合 2025—2026 年前沿的 Agentic RAG 与 Schema-First Text-to-SQL 能力。
二、为什么传统 RAG 不够用?
- 单轮检索召回不足:复杂问题需要多轮 Query Rewrite、子问题分解
- 表格/数据库无法问答:纯文档 RAG 无法回答「上季度华东区销售额同比」
- 幻觉无溯源:生成内容无法对应原文,合规场景不可用
- 权限粗放:同一知识库无法按部门/密级隔离
- 无法评测:上线后效果衰减,缺乏 Faithfulness 回归手段
三、技术架构
3.1 数据接入层(Ingestion)
- 文档:PDF、Word、PPT、Excel、Markdown、HTML、Confluence、SharePoint
- 网页:定时爬取 + 变更检测
- 数据库:表结构/metadata 同步(非行级,保护隐私)
- 解析:OCR(扫描件)、版面分析(保留标题层级、表格、脚注)
- 流水线:MinIO 对象存储 + 异步队列,支持 TB 级增量更新
3.2 切片与索引层(Chunking & Indexing)
- 语义切片:按段落/章节边界,overlap 128—256 token
- 结构化切片:表格独立 Chunk,保留表头与单元格坐标
- 双索引:Milvus 向量索引 + Elasticsearch BM25 倒排索引
- Metadata:部门、项目、密级、有效期、文档版本号
3.3 检索层(Retrieval)
模式一:Hybrid RAG(标准模式)
- Query Rewrite:HyDE / Multi-Query 扩展
- Parallel Recall:Dense(bge-m3)+ BM25 各取 Top-50
- Fusion:RRF 或加权合并
- Rerank:Cross-Encoder(bge-reranker-v2)精排 Top-8
- Context Compression:LLM 摘要压缩过长片段
模式二:Agentic RAG(复杂问答)
Agent equipped with 四工具:search(广搜)、find(文档内定位)、open(精读全文)、summarize(上下文压缩)。模型自主决定检索轮次与深度,行业 benchmark 表明 Agentic 相对单向量检索 Recall 可提升数倍。
模式三:Schema-First Text-to-SQL
- 对表/列/指标/Join 关系/历史 Query 建 Embedding 索引
- 并行向量检索 + 血缘扩展 + Cross-Encoder Rerank
- ACL 门禁过滤无权限表字段
- LLM 生成 SQL → 沙箱 EXPLAIN 校验 → 执行 → 自然语言解读
3.4 生成与溯源层
- 强制引用:答案每句标注 [doc_id:chunk_id] 可点击跳转
- 拒答策略:检索置信度低于阈值时明确告知「知识库无依据」
- 幻觉检测:LLM-as-Judge 对比生成与引用片段
- 多轮记忆:会话级上下文 + 指代消解
四、核心功能清单
| 功能 | 说明 |
|---|---|
| 混合检索 | 向量 + BM25 + RRF + Rerank 四段式 |
| Agentic 检索 | 多轮 search/find/open,适合跨文档推理 |
| Text-to-SQL | Schema 图谱 + Join 扩展 + 权限过滤 |
| 知识空间 | 多库隔离,按组织/项目授权 |
| 增量更新 | 文档变更 Diff 索引,版本回滚 |
| 评测中心 | Faithfulness / Relevance / Answer Correctness |
| API | REST + SSE 流式,OpenAI 兼容 |
五、典型场景深度说明
5.1 金融合规制度问答
接入内规、外规、监管函件 10 万+ 页。合规人员提问「关联交易审批阈值」→ Agentic 检索跨 3 份制度 → 引用具体条款 → 审计日志留存 5 年。
5.2 制造业设备运维
设备手册 + 故障案例库 + IoT 告警日志联合问答。「泵体振动超标可能原因」→ RAG 检索手册 + 相似历史工单 → 输出排查步骤与备件号。
5.3 经营问数
业务人员:「Q3 华南区各产品线毛利率排名」→ Schema-First 召回 sales_fact + product_dim → SQL 聚合 → 表格 + 解读。
六、性能与规模参考
| Chunk 规模 | 百万—亿级,增量索引分钟级 |
| 检索延迟 | Hybrid + Rerank P95 < 800ms(视硬件) |
| 召回提升 | Rerank 相对单向量 +10~30pp;Agentic 复杂题 +20pp+ |
| SQL 错误率 | Schema-First 可降低 50%+ 执行错误(视元数据质量) |
七、安全合规
- 字段级 ACL:行列权限继承自源系统或平台配置
- 密级标签:绝密/机密/内部/公开,检索时强制过滤
- 脱敏:PII 自动识别与掩码
- 审计:问答全记录,含检索片段与模型版本
八、部署与技术栈
技术栈:Python、Milvus、Elasticsearch、MinIO、LangGraph、Redis、PostgreSQL、MCP
Embedding:支持 bge-m3、text-embedding-3 等;可本地 GPU 部署
部署:私有化为主,CPU 检索 + GPU Embedding 混合
九、检索算法深度说明
9.1 Hybrid 融合策略
RRF(Reciprocal Rank Fusion)将向量召回排名与 BM25 排名融合,公式 score = Σ 1/(k+rank),k 通常取 60。对专业术语密集的制度文档,BM25 保证精确匹配;对口语化问法,向量保证语义泛化。二者互补是 enterprise RAG 标配。
9.2 Cross-Encoder Rerank
Bi-Encoder 召回快但交互浅;Rerank 阶段用 Cross-Encoder 对 Query-Chunk 对打分,计算量 O(n) 但 n 仅 Top-50,延迟可控。行业实践表明 Rerank 可将 MRR@10 提升 10—30 个百分点。
9.3 CSR-RAG 思想(结构化数据)
借鉴 CSR-RAG 论文:Contextual(语义相似历史 Query)、Structural(Schema 知识图谱)、Relational(Join 路径)三路并行召回,再 Relational 层做 Join 列筛选,将 Text-to-SQL 错误率显著压低。长境 Schema-First 模块即基于此思路工程化。
十、API 与集成示例
| API | 用途 |
|---|---|
| POST /rag/v1/query | 同步问答,返回答案 + citations[] |
| POST /rag/v1/query/stream | SSE 流式输出,首 token 延迟优化 |
| POST /rag/v1/ingest | 批量文档入库,返回 task_id |
| POST /rag/v1/sql | Text-to-SQL 专通道,返回 SQL + 结果集 + 解读 |
| GET /rag/v1/eval/run | 触发评测集回归,输出报告 |
十一、实施路线图(8 周)
- W1—2:数据源盘点、权限模型设计、选 200 份核心文档试点
- W3—4:Ingestion 流水线 + Hybrid 检索调参(Recall@10 目标 ≥0.85)
- W5:引用溯源 + 拒答策略 + 30 条评测集基线
- W6:(可选)Agentic 模式 / Text-to-SQL 接入
- W7:灰度 10% 用户,监控 Faithfulness / 延迟
- W8:全量 + 运维手册交付
十二、FAQ
Q:与 ChatPDF 类产品差异?
A:面向企业生产,强调 Hybrid+Agentic、Text-to-SQL、ACL、评测与审计。
Q:数据是否出域?
A:私有化部署下 Embedding/LLM 均可内网运行。
Q:扫描件 OCR 准确率?
A:依赖 OCR 引擎与版面复杂度,制度类 PDF 通常 ≥95% 可用;建议人工抽检 5% 样本。
Q:如何持续优化?
A:每周导入用户「点踩」问答进评测集,Rerank 阈值与切片策略按月回归。